AI‑сервер ASUS ESC N8A-E12 — 8× H100 SXM 80GB
Доставка по РФ и СНГ
Доставим оборудование в любую точку РФ и СНГ
Гарантия
Предоставляем гарантию до 12 месяцев
Юридическое сопровождение
Сопровождаем во всех юридических вопросах
Оплата для юр. лиц
Принимаем оплату от юр. лиц с НДС

Лидеры рейтинга РБК
Самые высокие темпы роста в майнинговой отрасли

Лучший дистрибьютор 2025
Отмечены наградой “Майнинг-дистрибьютер года” на событии Blockchain Life 2025.

Оператор майнинга
Обладаем официальным статусом оператора майнинговой инфраструктуры в России.
Дополнительная информация
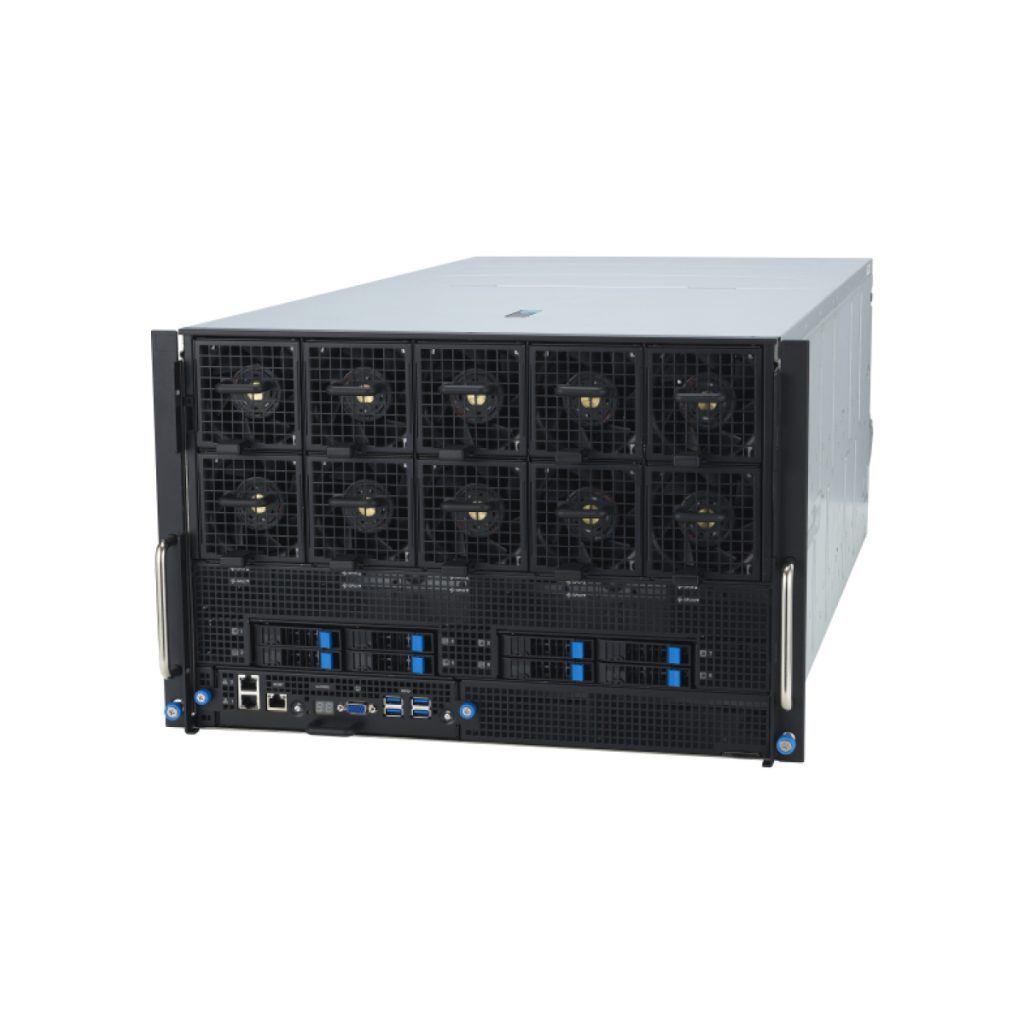
ASUS ESC N8A-E12 — производительный AI и HPC сервер формата 7U с восемью H100 SXM 80GB, предназначенный для обучения моделей, инференса, RAG‑систем, аналитики данных и multi‑GPU вычислений с высокой плотностью ускорителей.
Платформа построена на базе HGX H100 с NVLink и NVSwitch, обеспечивающими высокоскоростную межGPU‑коммуникацию и стабильную масштабируемость при распределённом обучении и inference‑нагрузках. Суммарный объём видеопамяти составляет 640 GB HBM3 (8×80 GB), что позволяет запускать крупные LLM в распределённом режиме, поддерживать длинный контекст и высокий уровень параллельных запросов.
Архитектура Hopper оптимизирована для современных AI‑нагрузок с поддержкой FP16, FP8 и INT8, обеспечивая высокую производительность при training, fine‑tuning и production inference.
Производительность GPU (суммарно на 8× H100 SXM):
- FP64 Tensor Core: 536 TFLOPS
- TF32 Tensor Core: 7 912 TFLOPS
- BF16 / FP16 Tensor Core: 15 832 TFLOPS
- FP8 Tensor Core: 31 664 TFLOPS
- INT8 Tensor Core: 31 664 TOPS
Совместимость с LLM:
- DeepSeek‑R1 685B (Q4) — ~404 GB VRAM — multi‑GPU запуск
- Qwen 3.5 397B FP8 — ~406 GB VRAM — полностью совместимо
- GPT‑OSS 120B — ~196 GB VRAM — полностью совместимо
- GigaChat 702B (Q4) — ~472 GB VRAM — multi‑GPU запуск
- Mistral Large 675B (Q4) — ~407 GB VRAM — полностью совместимо
- GLM‑5 (Q4) — ~456 GB VRAM — полностью совместимо
640GB VRAM позволяет запускать крупные модели без сильной квантизации, увеличивать batch size и поддерживать высокий throughput в production AI‑системах, включая RAG‑архитектуры, корпоративные ассистенты и аналитические платформы.
Совместимость с диффузионными моделями:
- Stable Diffusion XL 1.0 — полностью совместимо
- Flux 2 — совместимо при multi‑GPU распределении
- SD Turbo — полностью совместимо
- Kandinsky 5.0 (T2I / T2V) — полностью совместимо
Подходит для генерации изображений и видео высокого разрешения с распределением задач между GPU для увеличения пропускной способности и уменьшения задержек.
Ограничения:
- Для сверхкрупных моделей требуется tensor parallel или pipeline parallel
- При длинном контексте необходимо учитывать рост KV‑cache
- Модель платформы отмечена как EOL, возможны ограничения по срокам поставки
Детальная спецификация:
- GPU: 8× H100 SXM 80GB HBM3
- CPU: 2× AMD EPYC 9004 (SP5)
- RAM: до 6 TB DDR5 ECC RDIMM
- Накопители: 10× NVMe hot‑swap + 2× M.2 PCIe Gen5
- Форм‑фактор: 7U
- Гарантия: 1 год
Характеристики
Отзывов пока нет. Будьте первым!