AI‑серверы

AI‑сервер SOPHGO YU08-01 — ПАК «всё в одном» для LLM и ИИ-агентов (4× TPU, 1024GB)
RISC‑V сервер SOPHGO SRA1-20 — 2× SG2042 (128 ядер RISC‑V, 256GB DDR4, 2U)
RISC‑V сервер SOPHGO SRA3-40 — SG2044 с TPU (64 ядра RISC‑V, 128GB LPDDR5X, 4U)
RISC‑V сервер хранения SOPHGO SRB1-20 — 2× SG2042 (256GB DDR4, 8× 12TB HDD, 2U)
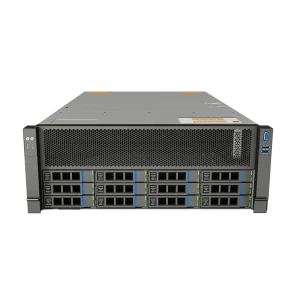
RISC‑V сервер хранения SOPHGO SRB3-40 — SG2044 с TPU (128GB LPDDR5X, 12 отсеков, 4U)
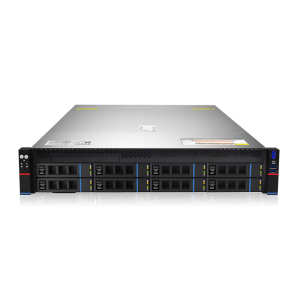
RISC‑V сервер SOPHGO SRM1-20 — 2× SG2042 с TPU‑ускорением (256GB DDR4, 2U)
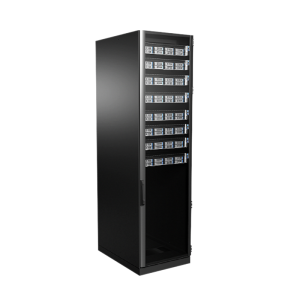
RISC‑V кластер SOPHGO SRC1-10 — 42U, 16× SG2042 (1024 ядра, 2TB DDR4, 192TB HDD)
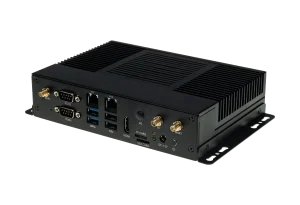
Edge AI‑сервер SOPHGO SE7 32-EA4-23 — BM1684X (32 TOPS INT8, 16GB, 32 каналов видео)
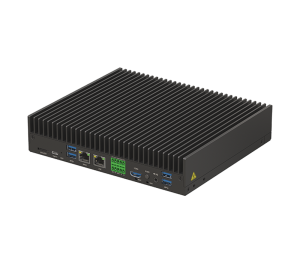
Edge AI‑сервер SOPHGO SE7 32-BP1-11 — BM1684X (32 TOPS INT8, 16GB, промышленный, IP40)
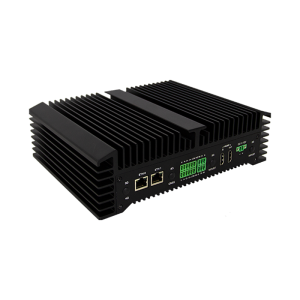
Edge AI‑сервер SOPHGO SE7 32-EP1-21 — BM1684X (32 TOPS INT8, 16GB, −40…+60 °C, IP40)
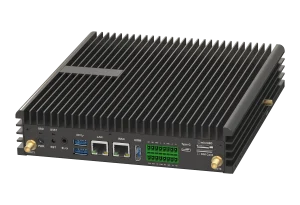
AI-серверы: какое оборудование нужно для нейросетей
Раздел объединяет оборудование для искусственного интеллекта — от модулей для камер до серверов на восемь ускорителей:
- GPU-платформы и GPU-серверы — обучение и инференс моделей на NVIDIA A100, H100, H200, B200, B300 и AMD Instinct, а также машины на 1–4 видеокарты и б/у серверы;
- AI-суперкомпьютеры — настольные станции на NVIDIA GB10 со 128 ГБ общей памяти и на GB300;
- Edge-серверы и AI-модули SOPHGO — видеоаналитика рядом с камерами при потреблении от 12,5 Вт;
- RISC-V серверы — вычисления и хранение данных на процессорах открытой архитектуры.
Начните с размера модели: от него зависит, сколько памяти ускорителей понадобится. Затем учтите программный стек — CUDA у NVIDIA, ROCm у AMD — и мощность, которую выдержит ваша серверная. Если нужной конфигурации нет в каталоге, менеджер подберёт её под задачу.
Частые вопросы
Чем GPU-платформы отличаются от GPU-серверов в каталоге?
В GPU-платформах собраны серверы на 6–8 ускорителей от Supermicro, ASRock Rack, GIGABYTE, ASUS, HPE и Dell. В GPU-серверах есть и такие машины, и конфигурации на 1–4 видеокарты, башенные сборки и б/у серверы.
Сколько памяти ускорителей нужно для LLM?
В формате FP16 модель занимает около 2 ГБ на миллиард параметров, в 4-битной квантизации — около 0,5–0,6 ГБ, плюс запас под контекст. Модели на 70 млрд параметров в FP16 нужно около 140 ГБ, то есть минимум два ускорителя по 80–96 ГБ.
Какой сервер брать для обучения, а какой для инференса?
Для обучения больших моделей берут серверы на 8 SXM-ускорителей со связью NVLink — H100, H200, B200 или B300. Для инференса и дообучения часто хватает 2–8 PCIe-карт, например RTX PRO 6000 с 96 ГБ памяти.